IndexService 服务介绍和演变
https://developer.aliyun.com/ebook/5890/read?spm=a2c6h.26392459.ebook-detail.2.12a4727eIQJS0X
abase,后演变为公司infra团队维护的最大kv存储。Index Service由我接手,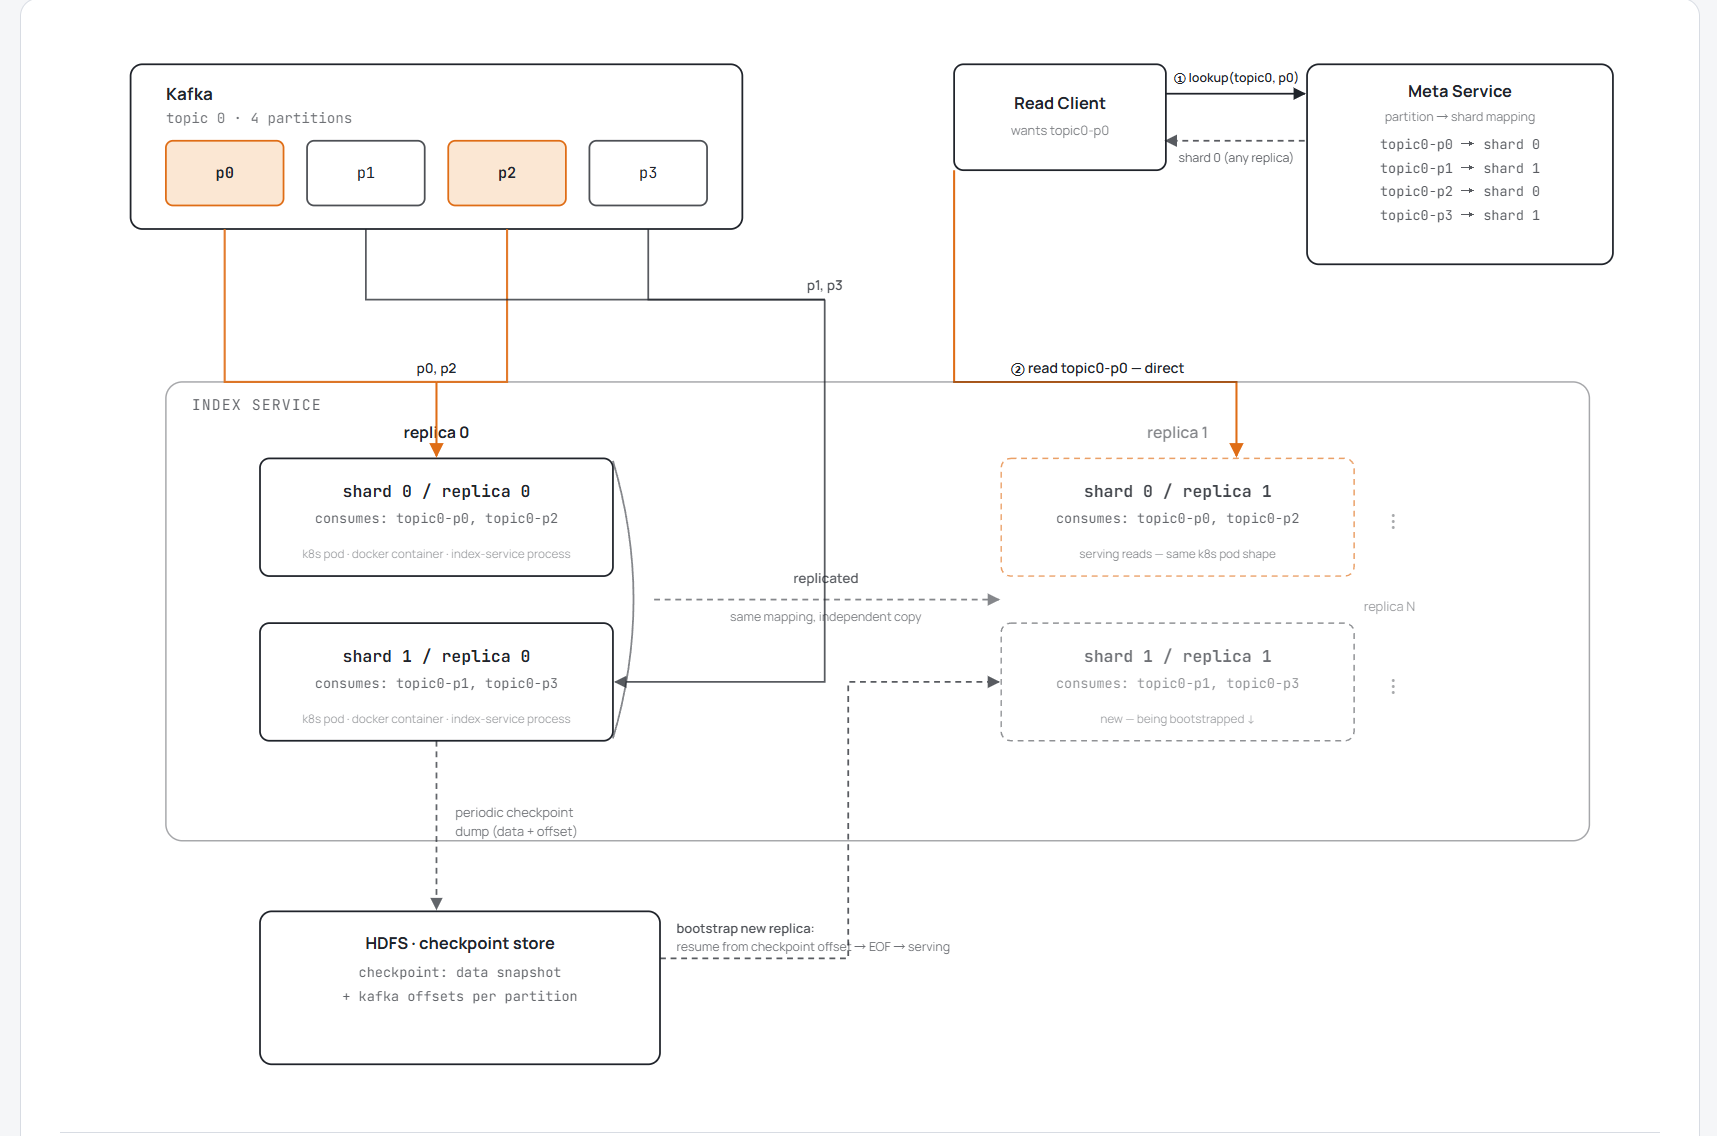
- 视频的正排信息,一个超大的pb,在典型场景抖音视频正排里大小大约1~2kB
- 倒排索引,比较经典的场景例如作者倒排,以author_id为key,以item_id为List中每个元素的id,同时支持每个item按score排序,类似于redis里的zset,并且取出来的元素支持Snake Merge,带权重的Snake Merge,按Score 排序等等。这里后面又根据场景做了很多分化
- 读多写少场景 + 1000以内截断,这是多数情况,此时甚至用不到rocksdb的Merge,直接read-modify-write,完事
- 写多读少场景 + 100000以内截断,此时既要用rocksdb的Merge,同时如果一个k的长度太长了,也要对单独的key做单独的rewrite
- 超长拉链,此时场景用于替代传统ES,支持与或非等语法树操作。后面这个服务没有继续使用流式写入,而是使用批式load的方案。
- 候选场景,主要服务于向量数据库,这里存的基本是候选特征,过一个简单的模型之后,获得向量,然后根据向量构建hnsw
- 长序列特征,主要存u侧行为数据,既支持批式也支持流式,批式数据从HDFS上加载,HDFS上数据由SSTWriter写入